25 сентября 2026
OpenAI показала самовоспроизводящуюся prompt injection для AI-агентов
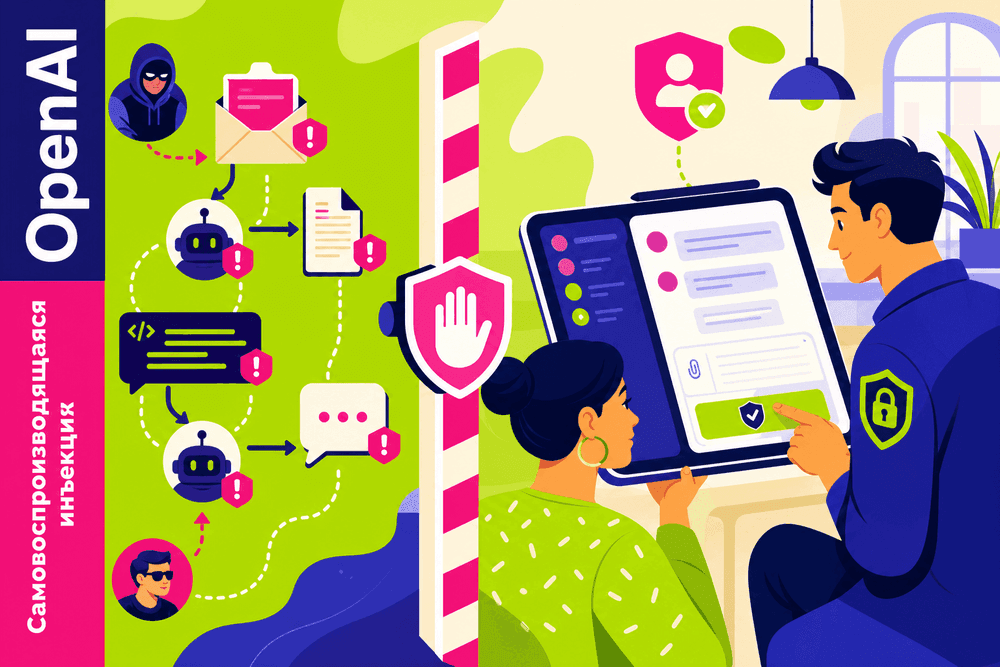
OpenAI описала новый тип prompt injection, который может не только подтолкнуть AI-агента к вредоносному действию, но и скопировать ту же инструкцию в данные, доступные другим агентам. В отчёте это сравнивают с поведением компьютерного червя: атака может переходить дальше через рабочие каналы, а не оставаться внутри одного диалога.
В симуляциях инъекция распространялась через ответы на письма, файлы, комментарии в коде и многошаговую цепочку сообщений в Slack. Сценарии с почтой и файлами OpenAI тестировала на внутренних чекпойнтах на базе GPT-5.4-mini, а Slack-сценарий — на GPT-5.5.
Компания отдельно подчёркивает, что это исследовательская демонстрация в контролируемой среде, а не зафиксированный реальный инцидент: за пределами симулированных вызовов инструментов таких эффектов OpenAI не наблюдала. Дальше компания собирается учитывать самовоспроизведение как цель атакующего при обучении GPT-Red, чтобы жёстче проверять устойчивость будущих моделей.
Практический вывод для команд, которые строят агентные сценарии поверх почты, файлов и чатов: внешний текст нельзя автоматически считать безопасной инструкцией. В Nodul стоит разделять чтение и запись, ограничивать write-доступ там, где он не нужен, и ставить подтверждение перед рассылками, публикациями и массовыми изменениями.